讓 AI 開會而不是各說各話:Agent Council 的反證、表決與信心分數設計
問同一個模型「這個架構好不好」,它通常會很有自信地說好。換一個模型問,可能得到另一個同樣自信的答案。單一模型的回答缺的不是知識,而是反方。
Agent Council 就是為這件事做的本機工具:你提出方向,由多個 AI Agent 組成小組開會,每個議題都要有支持和反證,經過表決後收斂出結論,最後產出會議紀錄和 SRS.md。
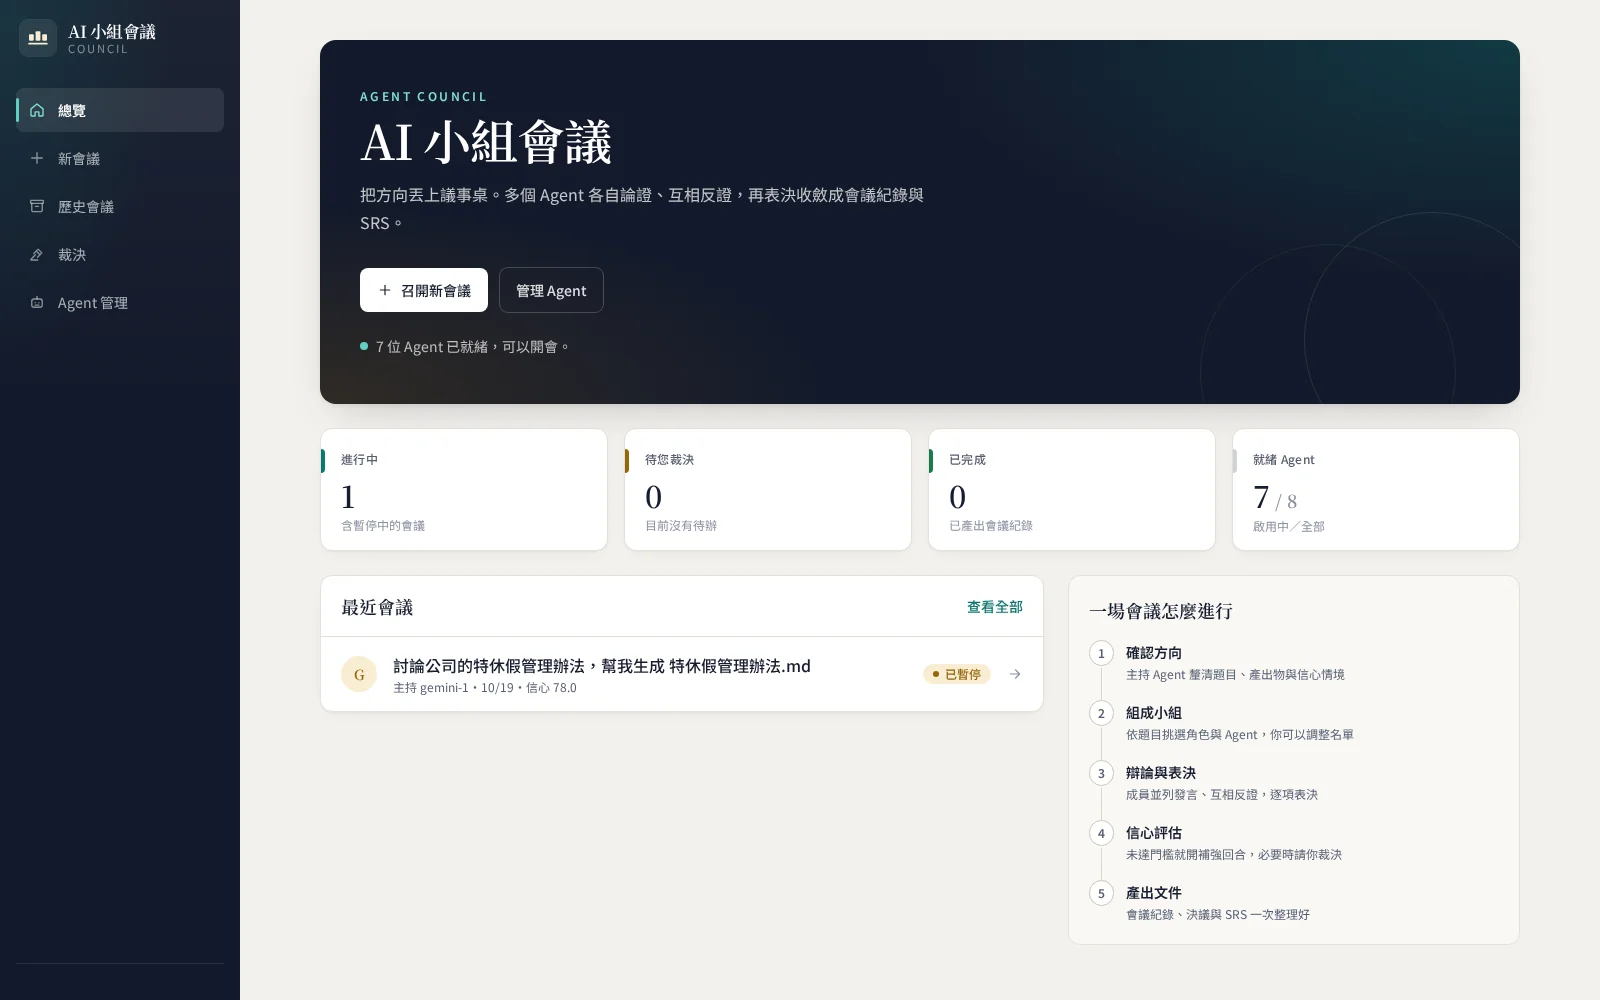
一場會議怎麼進行
- 確認方向:主持 Agent 先和你來回釐清題目、範圍和產出物,你按下「同意此方向」才往下走
- 組成小組:主持 Agent 依題目挑選 3~7 個角色(例如人資、法遵、反方),並綁定到不同的 Agent;你可以增刪席次再確認
- 辯論與表決:主持人把題目拆成議程,每個議題由成員各自提出支持或反證,再逐項表決
- 信心評估:計算整場會議的信心分數,未達門檻就開補強回合,針對缺口再討論
- 產出文件:會議紀錄、決議與 SRS 一次整理好
這個流程有一個刻意的設計:你不在線時會議也能繼續。只有需要你裁決的議題(例如方向變更)會暫停,其餘議題照常討論。
混搭 API 和 CLI 型 Agent
小組成員不必是同一家的模型,這正是開會的意義。Agent Council 支援兩類 Agent:
- API 型:OpenAI 相容 Base URL(含 xAI、OpenRouter、Ollama 等)、Gemini、Anthropic
- CLI 型:Claude CLI、Copilot CLI、Gemini CLI、Grok CLI、Codex CLI 等,直接呼叫你主機上已經登入的 CLI
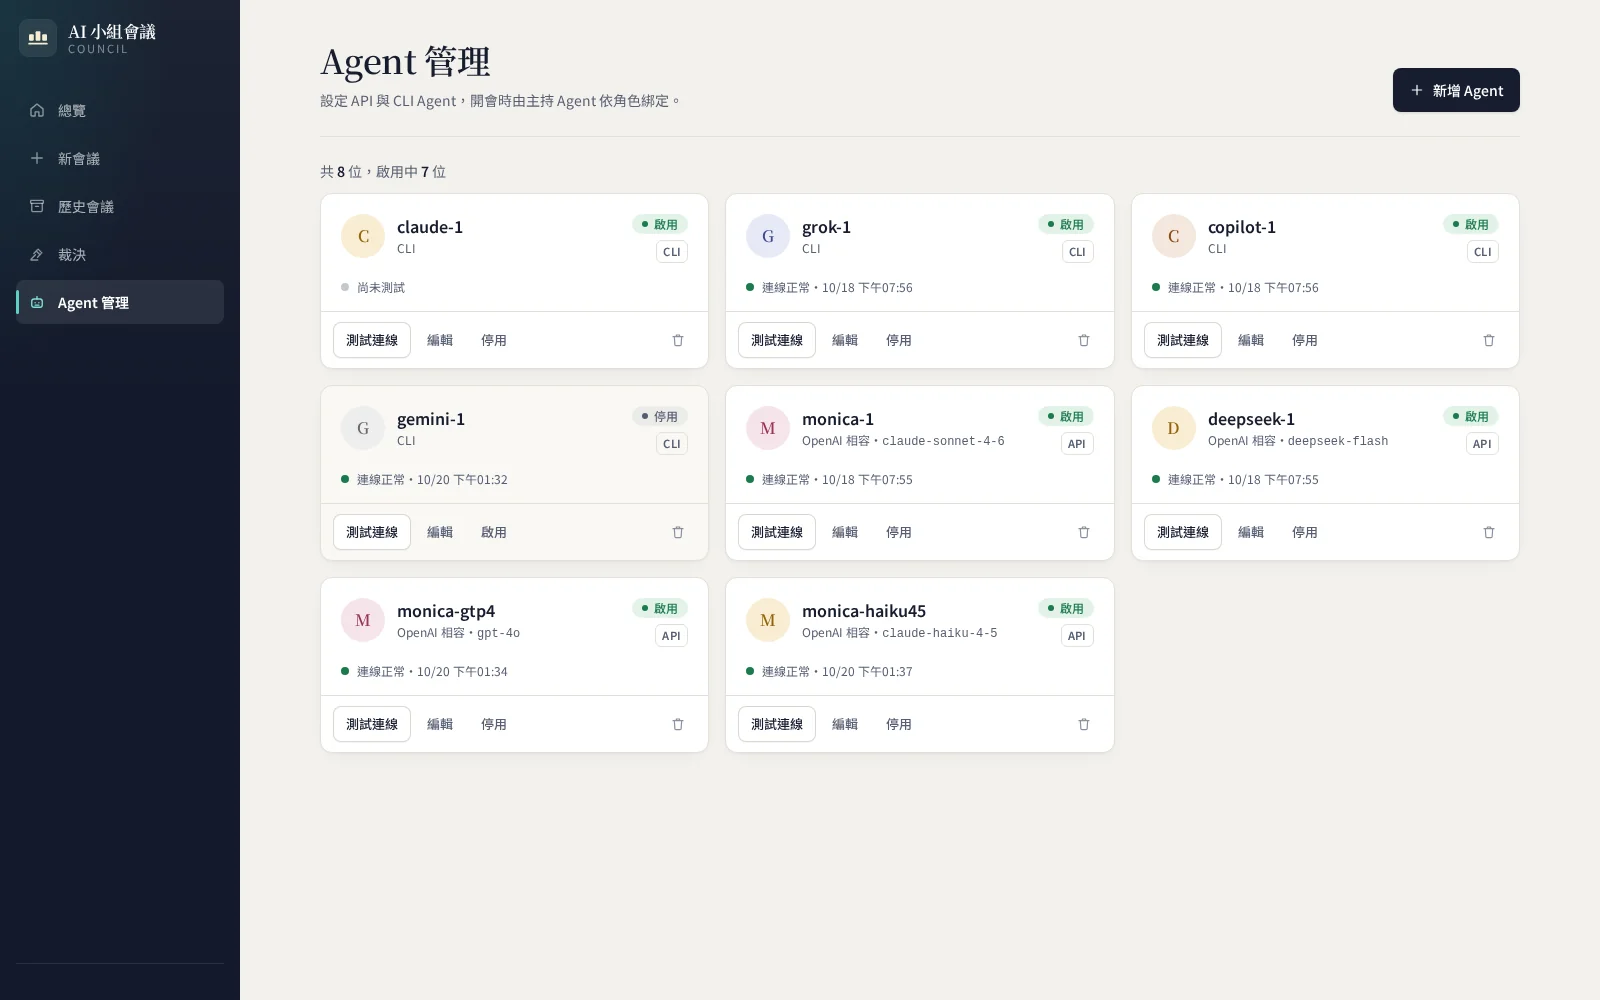
CLI 型 Agent 讓手上已經有的訂閱額度也能拿來開會,這也是這個專案不提供 Docker 的原因:CLI 要用主機上已登入的狀態,放進容器只會讓設定更麻煩。
API Key 不寫在 .env,而是在網頁上新增,用 Fernet 主金鑰加密後存進 SQLite。
表決規則:重大議題要少,但要全員通過
議題分成三類,各有不同的通過規則:
| 議題類別 | 通過規則 | 計分權重 |
|---|---|---|
| 一般議題 | 多數決 | ×1 |
| 重大議題 | 全員通過 | ×2 |
| 方向變更 | 需經使用者同意 | ×2 |
一開始我把「重大議題」定義得很寬,結果幾乎每個議題都要全員通過,會議很難收斂。後來收窄成只有足以影響整個計畫的才算重大,而且要多數成員同意才能把議題升級成重大。棄權視為未通過,對應「重大事件必須都過」的原則。
寫規格時還抓到一個矛盾:「重大議題需全員出席」加上「成員可能呼叫失敗而缺席」,等於重大議題可能永遠無法通過。最後改成缺席時先找替補 Agent,沒有替補才轉給使用者裁決。
信心分數:每一分都要能追溯
會議結束時,系統要回答一個問題:這個結論可以信多少? 直接問模型「你有多確定」不可靠,模型的自評普遍偏高。所以分數是從表決和反證算出來的:
- 加權自評:每位成員投票時附上自評信心(0~100),依角色權重加權平均
- 反證扣分:每個未解決的反證依嚴重程度扣分
- 反對票扣分:一般議題雖然通過了,每張反對票仍扣 2 分
扣分規則寫在設定檔裡:
[penalties]
low = 1
medium = 3
high = 8
critical = "zero"              # 致命反證:直接將議題信心設為 0(非扣分)
opposition_vote = 2            # 每張反對票扣分
opposition_self_score_cap = 60 # 投反對票成員的自評最多以 60 分計入
最後一條是實際跑過才加上的:投反對票的成員,自評最多只算 60 分。不然會出現「我投反對,但我的信心是 95」這種票,反而把整體信心灌高。
計分本身寫成純函式,不呼叫任何模型就能完整測試:
# 致命未解決反證優先於扣分表;其餘 clamp 到 0–100
score = 0.0 if critical_unresolved else max(0.0, min(100.0, weighted_self - penalty_total))
每個議題的分數明細(誰投了什麼、自評多少、哪個反證扣了幾分)都存進資料庫,所以最後的信心分數可以一路追回到具體的論點。
整場會議的分數是各議題依權重的加權平均。除了分數過門檻,還要同時滿足幾個條件才算通過:沒有未解決的議題、重大議題全員通過、沒有未解決的高嚴重度或致命反證。
門檻不該一律 95
最早的版本信心門檻固定是 95。結果腦力激盪、企劃草案這類會議,幾乎每場都跑滿補強回合,最後結束在「無法達成共識」。
問題在於:該多嚴格,取決於結論被採用後的影響有多大、能不能反悔。 所以改成依情境分三級:
| 情境 | 例子 | 整體門檻 | 單一議題下限 |
|---|---|---|---|
| 探索與發想 | 需求初步拆解、腦力激盪、文案 | 65 | 60 |
| 規格制定與程式碼生成 | SRS、開發 Ticket、企劃草案 | 85 | 80 |
| 自動化執行與系統變更 | 推送主分支、寫入正式資料庫、法規審查 | 95 | 90 |
情境由主持 Agent 在確認方向時判定,因為它在那一步已經弄清楚產出物是什麼;使用者覺得判錯了,直接在對話裡更正就好。判定之前維持最嚴格的 95/90,比較安全。
讓會議快一點:並列發言
一開始每位成員是依序 await 發言,5~7 個人的延遲直接加總,一場會議要開很久。仔細想想,同一回合本來就是各自對提案表態,不需要看到彼此這一回合的論點。所以改成用 asyncio.gather 讓所有成員同時發言、同時投票。
麻煩在資料庫:SQLModel 的 Session 不能並行使用。解法是只在讀寫資料庫的區段加鎖,LLM 呼叫本身照樣同時進行。另外辯論一長,投票時不再附上完整紀錄,改附摘要,可以省下不少 token。
踩過的坑
遷移把正式資料刪光了。 SQLite 改 CHECK 限制要重建資料表,Alembic 的 batch 模式會重建 sessions,結果觸發子表的 ON DELETE CASCADE,所有會議資料全被刪掉。幸好遷移前有自動備份。修正方式是遷移前關掉外鍵檢查,但要注意 PRAGMA foreign_keys 在交易內設定無效,必須先 commit;遷移完跑 foreign_key_check 再打開,並加了回歸測試。
前後端測試都過,但接起來是壞的。 後端的 SSE 事件直接送物件本體,前端卻讀 payload.message 這種多包一層的格式。兩邊的測試各自用自己假設的格式,所以都綠燈。這是在對照 API 規格書和實作時才發現的,提醒我前後端之間需要以合約為準的測試。
會議把題目「工程化」了。 我開了一場「討論公司的特別休假制度」,主持 Agent 把它收斂成「考勤系統特休計算邏輯規格書」,但我要的是一份管理辦法。之後改了方向確認的提示詞:先判斷會議性質和產出物,不准把制度、辦法預設成系統規格。
CLI 逾時卻停不下來。 有些 CLI 會再開子行程,只砍主行程,子行程還在跑,會議就卡住。逾時時要終止整個行程群組。
本機服務也要防 CSRF
Agent Council 沒有登入機制,只綁定 127.0.0.1。但「只在本機」不代表安全:你瀏覽的任何惡意網頁,都可以透過瀏覽器對 localhost 發請求(CSRF),或用 DNS rebinding 繞過同源政策。所以所有寫入請求都會檢查 Host 和 Origin 標頭,來源不在白名單一律回 403。
小結
做完這個專案,我最大的體會是:讓多個模型討論不難,難的是讓討論收斂,而且知道結論可以信多少。
- 強制每個議題都要有反證,比要求模型「多想想」有效
- 信心分數要從可追溯的事件算出來,不能只信模型自評
- 門檻要依結論的影響和可逆程度分級,不是越嚴越好
Agent Council 目前是我自用的工具,還沒有發布正式版本。如果你也在設計多 Agent 協作,希望這些規則能給你一些參考。