讓 Claude Code、Gemini、Grok 一起上班:用 SQLite 與 git worktree 打造多 AI Agent 派工器
手上同時有 Claude Code、Gemini CLI、Grok CLI、Copilot CLI 好幾個訂閱,每個都能在終端機裡自己寫程式。問題是:一次只開一個太浪費,同時開好幾個又會互相踩腳。
所以我寫了 Recall:一個在 WSL2 裡執行的派工器。它從專案的 TASKS.md 讀出任務清單,把可以開工的任務派給閒置的 agent,讓每個 agent 在自己的 git worktree 裡工作,驗證通過後自動合併回主分支,並記錄每次執行的成敗。
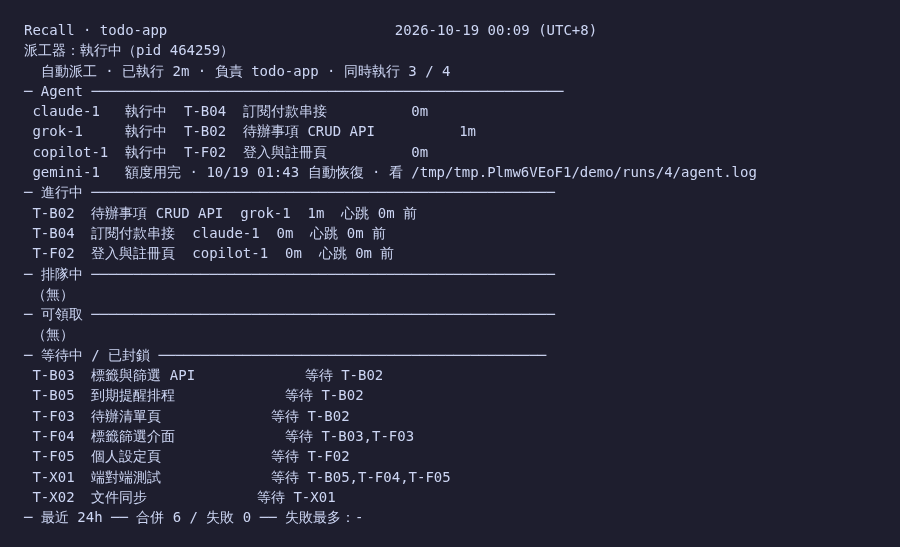
這篇不談怎麼安裝,而是整理過程中幾個關鍵的設計決策,以及它們為什麼長成現在這樣。
多個 agent 同時開工,會出什麼事?
一開始我直接開三個終端機,讓三個 agent 各自照著 TASKS.md 領任務。很快就遇到四個問題:
- 重複領取:兩個 agent 同時看到 T-B02 還沒人做,一起開工
- 互踩檔案:大家都在同一個工作目錄改,誰的修改都可能被別人蓋掉
- 主分支被弄壞:某個 agent 宣稱完成,但測試其實沒過,後面的任務就建立在壞掉的程式上
- 卡關沒人知道:某個 agent 每日額度用完,一直失敗、一直被重派
Recall 的每個機制,幾乎都是在對付這四件事。
整體架構
TASKS.md ──import──▶ SQLite(tasks / prerequisites / runs / outcomes / events)
                          │
                    派工器(前景程式,flock 保證只有一個)
                          │ 挑閒置 agent + 可領取任務
                          ▼
              git worktree(每個 run 一個新分支)
                          │ agent CLI 在裡面工作,完成後回報 outcome
                          ▼
         rebase 到主分支 → 跑驗證指令 → fast-forward 合併 → 任務 done
幾個基本原則:
- 純 Python 標準函式庫,不需要
pip install任何東西 - 沒有常駐服務:派工器是你自己開著的前景程式,Ctrl+C 就停
- 資料只有一個來源:任務狀態以 SQLite 為準,
TASKS.md只是任務內容的編輯來源
設計 1:領取鎖只是一條條件式 UPDATE
防止重複領取最直覺的做法是加一張鎖表,但其實一條 UPDATE 就夠了:
UPDATE tasks
SET status = 'in_progress', status_changed_at = :now,
    claimed_by = :agent, claimed_at = :now, heartbeat_at = :now,
    claim_expires_at = datetime(:now, '+' || :ttl || ' minutes')
WHERE region = :region AND id = :id AND status = 'todo'
  AND NOT EXISTS (
      SELECT 1 FROM task_prerequisites p
      JOIN tasks pt ON pt.region = p.region AND pt.id = p.prereq_id
      WHERE p.region = tasks.region AND p.task_id = tasks.id AND pt.status <> 'done')
WHERE status = 'todo' 是關鍵:兩個 agent 同時領,只有一個的 rowcount 會是 1,另一個拿到 0,就知道被搶走了。前置任務沒完成的也一併擋掉。
要讓這招在多個行程之間可靠,SQLite 有兩個細節一定要處理:
- 寫入交易一律用
BEGIN IMMEDIATE。預設的 DEFERRED 交易會先拿讀取鎖,兩個連線同時要升級成寫入鎖時,其中一個會直接失敗,而且不會套用busy_timeout等待 - Python 的
sqlite3要設isolation_level=None。不然它會自動幫你送BEGIN,你就沒辦法自己下BEGIN IMMEDIATE
我用 12 個行程同時對 8 個可領取任務執行 recall next 做驗證:8 個任務各被一個 agent 領走,沒有重複,前置未完成的任務也沒被派出。
用租約,不用永久鎖
agent 當掉時,鎖不會自己消失。所以領取時寫入的是租約到期時間(claim_expires_at),agent 或派工器定期送 heartbeat 續約,逾時就回收。
回收也不需要背景程式:每個寫入型指令開頭順便檢查一次就好。這裡還有個小陷阱:回收要寫兩筆資料(事件紀錄和任務狀態),如果各自呼叫 datetime('now'),剛好跨過一秒時,就會出現任務被回收了、卻沒有對應事件的情況。所以改成交易一開始取一次 now,整個交易共用。
設計 2:每個 run 一個 worktree,合併才算完成
每次派工,Recall 都從最新的主分支開一個新的 worktree 和分支給 agent。就算是同一個任務的第二次重試,也不沿用上次失敗的分支,避免把錯誤繼續疊上去。
agent 做完後回報 recall outcome --result success,但這時候任務還不算完成。派工器接手收尾:
- 把 agent 沒 commit 的變更補 commit
- 還原 agent 對
TASKS.md的修改(很多 agent 習慣直接改這個檔案的狀態,多個分支同時改必定衝突) - rebase 到主分支
- 在 rebase 之後跑驗證指令(例如
pytest -q) - 只用
git merge --ff-only合併
為什麼要「合併成功才算 done」?因為後續任務是靠前置任務的 done 狀態解鎖的。如果 agent 一回報成功就標成 done,後面的任務會從還沒包含前置程式碼的舊主分支開工。
只用 rebase 加 fast-forward 還有另一個好處:主分支上的每一個狀態都經過驗證,歷史也保持線性。合併由派工器單一執行緒依序處理,不會有兩個分支同時合併。
設計 3:不是每次失敗都是 agent 的錯
每個 agent 有一個信心權重:成功 +0.30、失敗 −0.20,截斷在 [0, 1]。之後可以依任務類型查詢「哪個 agent 做這類任務比較可靠」。
def apply_outcome(weight, result, deltas, lo, hi):
    """加上對應 delta 後截斷到 [lo, hi]。"""
    return round(min(max(weight + deltas[result], lo), hi), 4)
但很快就發現,很多失敗根本不是 agent 能力的問題。所以這幾種情況不計入失敗、不扣權重:
- 合併衝突:這是協調問題,交給人處理
- 派工器當掉(被
kill -9或 WSL 關機):重啟後把遺留的 run 標成orphaned,任務放回可領取 - 額度用完:從 agent 日誌最後 20 行比對
usage_limit_reached、HTTP 429、insufficient_quota等字樣,判定成rate_limited
額度用完的處理特別值得一提。Claude 的錯誤訊息會寫重置時間,例如 resets 3:30pm (Asia/Taipei)。Recall 會解析這個時間,讓 agent 冷卻到那個時間再多等一分鐘,然後自動恢復;解析不到才退回固定冷卻 30 分鐘。固定冷卻常常不是太短就是太長,從訊息解析準確多了。
之前的版本是「同一個 agent 連續 3 次失敗就暫停,要人重啟派工器」,碰到每日額度這種情況實在太重,半夜跑的任務隔天早上才發現全卡住。
設計 4:連續任務的換手,以及「互相禮讓」的 bug
有一條依賴鏈 A → B → C 時,如果都讓同一個 agent 做,它會一路順著自己的思路寫下去,其他 agent 閒著。所以加了一條規則:挑到的任務如果前置是自己剛做完的,而且有別的空閒 agent,就讓給對方。
結果在示範環境卡住了。T-X01 有兩個前置,一個是 grok 做的,一個是 claude 做的。兩個 agent 都認為「這是我剛做完的延續,應該讓給對方」,於是誰都不接。
修正後的規則是:只讓給「沒做過任何前置」的 agent;找不到這樣的人,就自己接。這種 bug 用單元測試很難想到,是跑真實的依賴圖才浮出來的。
看得到才管得動
派工器在背景跑,人總要知道現在發生什麼事。Recall 有兩種看板:終端機版的 recall status --watch(上面那張圖),以及只綁定 127.0.0.1 的網頁儀表板。
網頁版有一頁做成了像素風格的工程師辦公室:每個 agent 是一位工程師,執行中坐在位子上,停用時去沙發區休假,需要人工判斷時走到右上角的 BOSS 前面排隊。
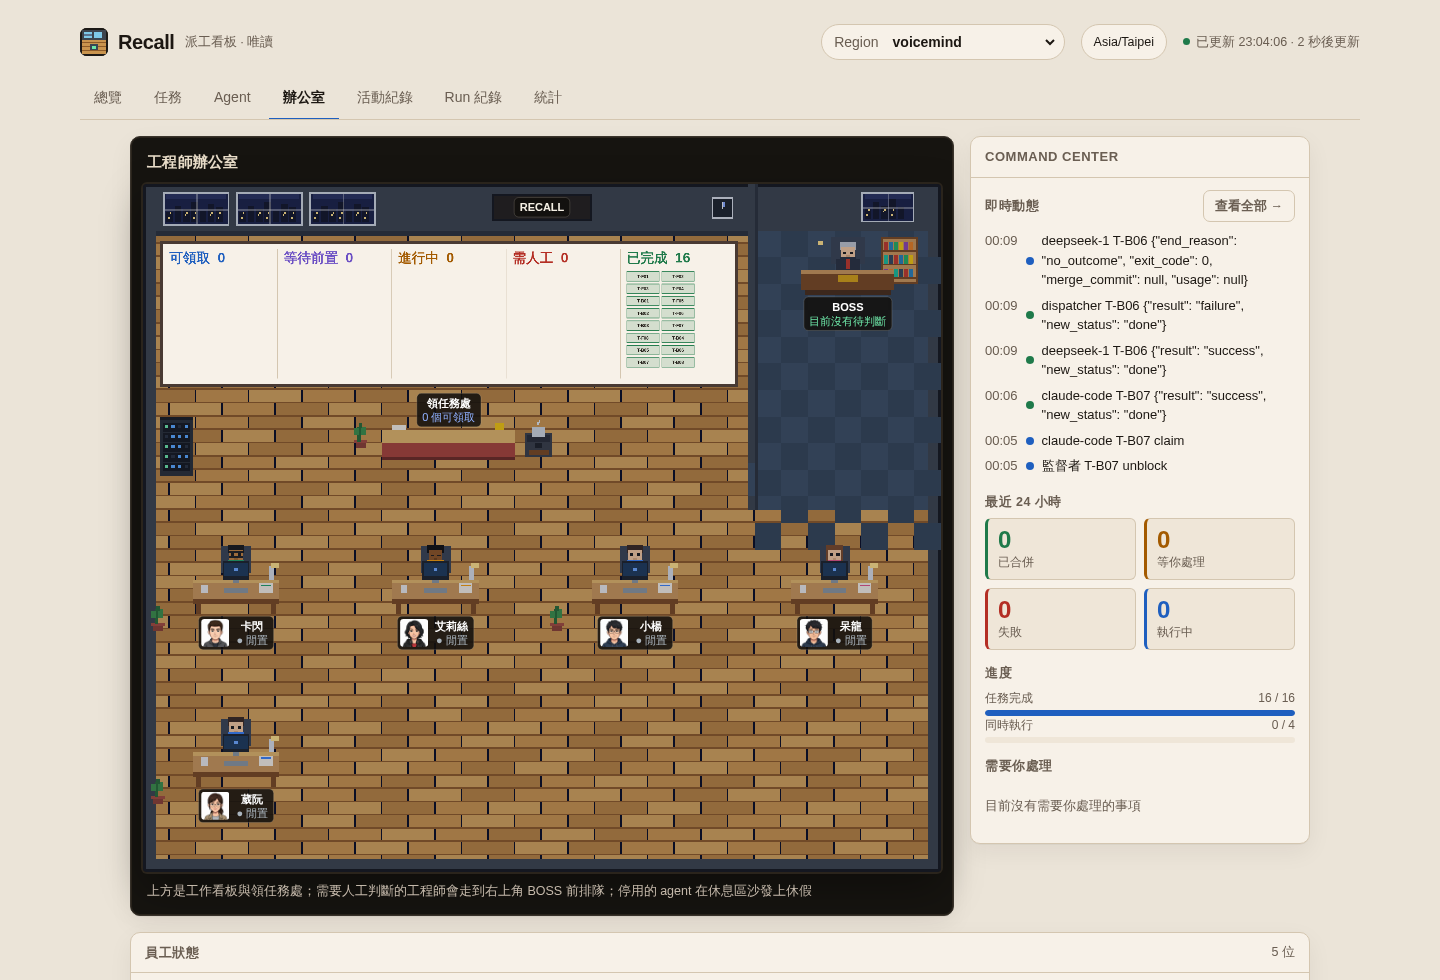
這頁說穿了只是把狀態換成角色位置,但一眼就看得出「誰在等我」。比起掃一張表格,實際用起來直覺很多。
踩過的坑
開發日誌裡記了不少坑,挑幾個比較有參考價值的:
用 pkill -f 把自己的 shell 殺掉。 想清掉殘留的 agent 行程,結果 pattern 剛好出現在自己這條 bash 指令的命令列裡,連同自己一起殺了(結束碼 144)。之後一律讀 /proc/<pid>/cmdline 判斷,不再用 pkill -f。
測試裡的固定時間會過期。 測試 helper 把租約到期時間寫死成某一天,那天一過,所有預設「進行中」的任務都被當成逾時回收,一整批測試同時壞掉。預設值改成遙遠的未來,需要逾時的測試再明確傳入過去的時間。
SQLite 不能 ALTER CHECK 限制。 要讓 runs.status 多接受一個 rate_limited,一般做法是重建資料表,但重建會觸發外鍵的 ON DELETE SET NULL,其他表裡的 run_id 全部被清空。最後改用文件記載的方式直接修改 sqlite_master 放寬允許值。另外 executescript() 會先自動 COMMIT,跳出你的交易,所以 migration 要逐句執行。
agent 的 shell 工具會清掉環境變數。 派工器用環境變數 RECALL_RUN_ID 告訴 agent 這次的 run 編號,但某個 agent 的 bash 工具會重設環境,回報時拿不到 run id。結果回報被當成手動回報,任務直接標成 done,程式碼卻沒有合併。修正方式是兩邊都不依賴對方:任務說明裡寫明完整的回報參數,沒有 run id 時再自動對上同一個 agent 在該任務進行中的 run。
本機服務的 race condition。 派工器先啟動 agent 行程,才把 run 從 queued 改成 running。很快的 agent 會在這之間就回報 outcome,被拒絕,結果被當成「沒有回報」。
安全提醒
無人看管的 agent 必須用自動核准模式執行,例如 claude -p --permission-mode bypassPermissions,也就是說它可以在 worktree 裡執行任何指令。Recall 用「每個 run 一個 worktree」和「合併前驗證」來限縮影響範圍,但擋不住 agent 讀寫 worktree 以外的檔案。
所以我的做法是:不用 root 執行派工器;要更強的隔離,就另開一個 Linux 使用者。如果用 Copilot CLI,記得關掉它內建的 GitHub MCP,不然 agent 會帶著你的 GitHub 權限,能開 PR、改 issue,超出「只在本機 worktree 工作」的範圍。
小結
回頭看,Recall 最核心的其實不是派工演算法,而是幾個很樸素的原則:
- 一條條件式 UPDATE 加上租約,就能解決大部分的並行領取問題
- 每個嘗試都從乾淨的主分支開始,合併成功才算完成
- 把「環境問題」和「能力問題」分開記帳
- 寧可讓一個人看得懂現在的狀態,也不要讓系統默默卡住
Recall 目前是我自用的工具,還沒有公開發布。如果你也在嘗試讓多個 coding agent 協作,希望這些取捨對你有幫助。